Kapitel 5 · vollständige deutsche Übersetzung
Studiendesign und Methoden
Kapitel 5: Studiendesign und Methoden
- Studiendesign
- Studiengruppe
- Stichprobengröße
- Ein- und Ausschlusskriterien sowie technische Bildeigenschaften
- Merkmale der Studiengruppen
- Studienmethoden
5.1 Studiendesign
- Teil 1: retrospektive Untersuchung der Akten und topographischen Bilder von Patientinnen und Patienten, die in der Abteilung für Augenheilkunde und Augenchirurgie des Universitätskrankenhauses Al-Mouassat der Universität Damaskus topographisch untersucht wurden. Ziel war, möglichst viele Bilder zu sammeln und zu klassifizieren, deskriptiv-statistische Analysen durchzuführen und die Daten für das Training des KI-Systems zu verwenden.
- Teil 2: Querschnittsuntersuchung zur Bestimmung der Leistungsfähigkeit des KI-Systems.
5.2 Studiengruppe
Teil 1 sollte durch die Prüfung alter Akten möglichst viele Bilder zum Training des Systems sammeln und deskriptiv-statistisch auswerten. Teil 2 bestand aus einer Zufallsstichprobe von Patientinnen und Patienten, die die Augenambulanz des Universitätskrankenhauses Al-Mouassat aufsuchten.
5.3 Stichprobengröße
Für Teil 1 wurde die erforderliche Größe einer deskriptiven Studie bei Alpha = 0,05, Beta = 0,05 und einer Effektgröße von 0,05 mit G*Power 3.0.10 berechnet. Für eine Teststärke von 95 % waren 356 Patientinnen und Patienten erforderlich. Für Teil 2 wurde bei Alpha = 0,05, Beta = 0,05, einer Odds Ratio von 2 und einem Anteil diskordanter Paare von 0,3 mit G*Power 3.0.10 eine erforderliche Stichprobe von 380 Augen für eine Teststärke von 95 % berechnet.
5.4 Ein- und Ausschlusskriterien und technische Bildeigenschaften
Einschluss: Alter über 10 Jahre; Kooperation am Topographiegerät zur Aufnahme eines technisch geeigneten Bildes (Teil 2) oder Vorliegen eines technisch geeigneten früheren topographischen Bildes (Teil 1).
Ausschluss: fehlende Kooperation während der Aufnahme; frühere Bilder ohne technische Eignung; Kinder unter 10 Jahren; schwere trockene Augen und Erkrankungen der Augenoberfläche; Hornhautdystrophien und -degenerationen; andere ektatische Hornhauterkrankungen; frühere Augenoperationen, insbesondere an der Hornhaut; Hornhautnarbe jeder Ursache außer Keratokonus.
Technische Bildeigenschaften: Die Software Phoenix v2.0.0.3 des SIRIUS-Geräts wurde verwendet, um die technische Eignung zu prüfen. Das Gerät bewertet Coverage und Anteil nicht bearbeiteter Daten (Not Edited) der Scheimpflug-Kamera sowie Coverage und Zentrierung (Centration) der Keratoskopieaufnahmen. Daraus entscheidet es, ob das Bild technisch geeignet ist (CSO, 2018).
5.5 Merkmale der Studiengruppen
5.5.1 Trainingsgruppe
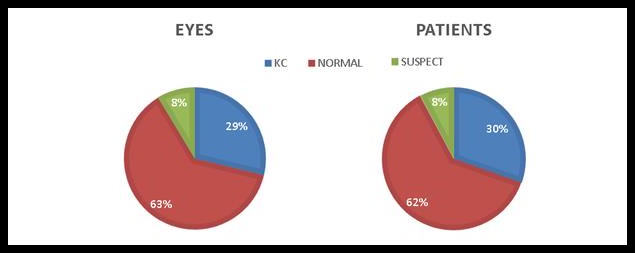
Die Trainingsstichprobe umfasste 987 Patientinnen und Patienten in drei Diagnosegruppen (Abb. 42): 300 keratokonische (KC; 30,39 %), 610 normale (NORMAL; 61,80 %) und 77 verdächtige (SUSPECT; 7,8 %). Auf Augenebene umfasste sie 1.943 Augen: 559 KC (28,73 %), 1.217 normale (62,67 %) und 167 verdächtige Augen (8,6 %).
Nach Geschlecht waren 483 Frauen (48,9 %) und 504 Männer (51,1 %) vertreten; das Verhältnis Männer zu Frauen betrug 1,041753653. Der Chi-Quadrat-Test zeigte keinen statistisch signifikanten Unterschied zwischen Männern und Frauen in den drei Gruppen (p > 5 %; Tabelle 6).
Tabelle 6: F 483 (48,9 %, kumulativ 48,9 %), M 504 (51,1 %, kumulativ 100,0 %), Gesamt 987 (100,0 %).
Das Alter lag zwischen 10 und 87 Jahren, der Mittelwert betrug 31,89 Jahre. Der Kolmogorov-Smirnov-Test ergab p = 0,000; das Alter war nicht normalverteilt und es wurden nichtparametrische Tests verwendet (Tabellen 7–8).
Tabelle 7: N = 987; Spannweite 77,0; Minimum 10,0; Maximum 87,0; Mittelwert 31,739; Standardabweichung 13,1865; gültiges N = 987.
Tabelle 8: Kolmogorov-Smirnov 0,157, df 987, Signifikanz 0,000; Shapiro-Wilk 0,874, df 987, Signifikanz 0,000; Lilliefors-Signifikanzkorrektur.
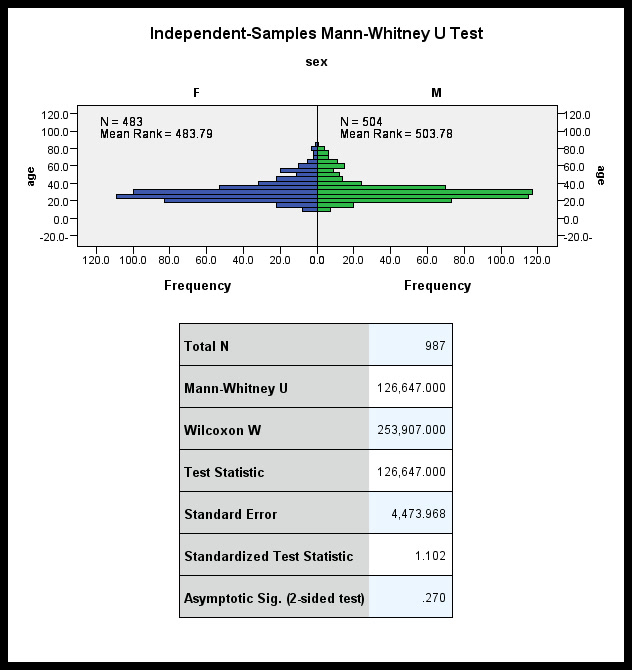
Das mittlere Alter betrug bei Frauen 32,4 und bei Männern 31,37 Jahre. Der Mann-Whitney-Test zeigte keinen signifikanten Unterschied (p = 0,270; Abb. 43).
Tabelle 9: Frauen Mittelwert 31,20, 95-%-KI 30,08–32,33, Median 28, SD 12,583, Minimum 10, Maximum 85; Männer Mittelwert 32,24, KI 31,04–33,44, Median 29, SD 13,732, Minimum 10, Maximum 87.
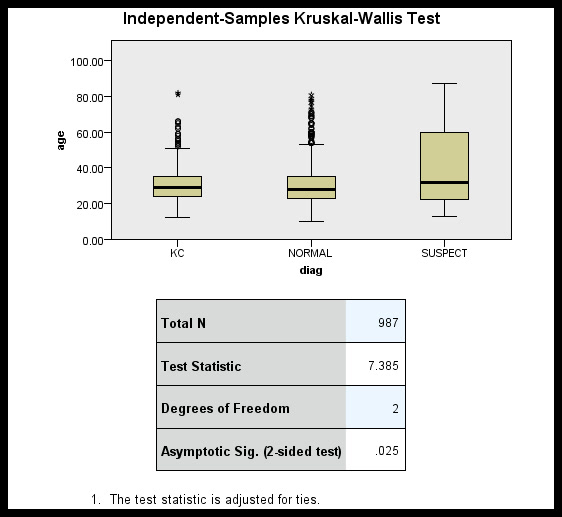
Nach Diagnose lagen die Mittelwerte bei KC 30,97 (12–82 Jahre), NORMAL 31,03 (10–81 Jahre) und SUSPECT 40,32 (13–87 Jahre). Der Kruskal-Wallis-Test zeigte einen signifikanten Unterschied (p = 0,025; Tabelle 10; Abb. 44).
Tabelle 10: KC Mittelwert 30,97, KI 29,71–32,22, Median 29, SD 11,054, Minimum 12, Maximum 82; NORMAL 31,03, KI 30,03–32,02, Median 28, SD 12,531, Minimum 10, Maximum 81; SUSPECT 40,32, KI 35,58–45,06, Median 32, SD 20,875, Minimum 13, Maximum 87.
5.5.2 Testgruppe
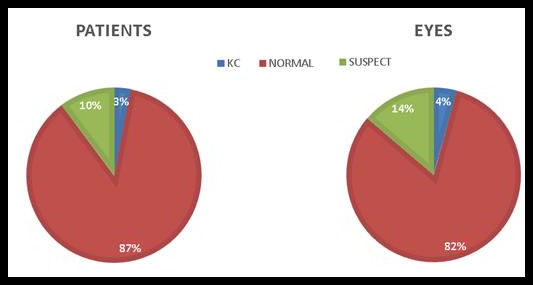
Die Teststichprobe umfasste 211 Patientinnen und Patienten (Abb. 45): 9 KC (4,27 %), 173 normale (81,99 %) und 29 verdächtige (13,74 %). Auf Augenebene umfasste sie 422 Augen: 13 KC (3,08 %), 366 normale (86,73 %) und 43 verdächtige Augen (10,19 %).
Nach Geschlecht umfasste die Testgruppe 91 Frauen (43,1 %) und 120 Männer (56,9 %); das Verhältnis Männer zu Frauen betrug 1:1,318. Der Chi-Quadrat-Test zeigte keinen signifikanten Unterschied zwischen den drei Gruppen (p > 5 %; Tabelle 11).
Tabelle 11: Verteilung der Testgruppe nach Geschlecht und Diagnose mit Chi-Quadrat-Test.
Das Alter lag zwischen 11 und 67 Jahren, der Mittelwert betrug 27,507 Jahre (Tabelle 12). Der Kolmogorov-Smirnov-Test ergab p = 0,000; das Alter war nicht normalverteilt (Tabelle 13).
Tabelle 12: N = 422; Spannweite 56,0; Minimum 11,0; Maximum 67,0; Mittelwert 27,507; SD 12,4867; gültiges N = 422.
Tabelle 13: Kolmogorov-Smirnov 0,273, df 422, Signifikanz 0,000; Shapiro-Wilk 0,786, df 422, Signifikanz 0,000; Lilliefors-Korrektur.
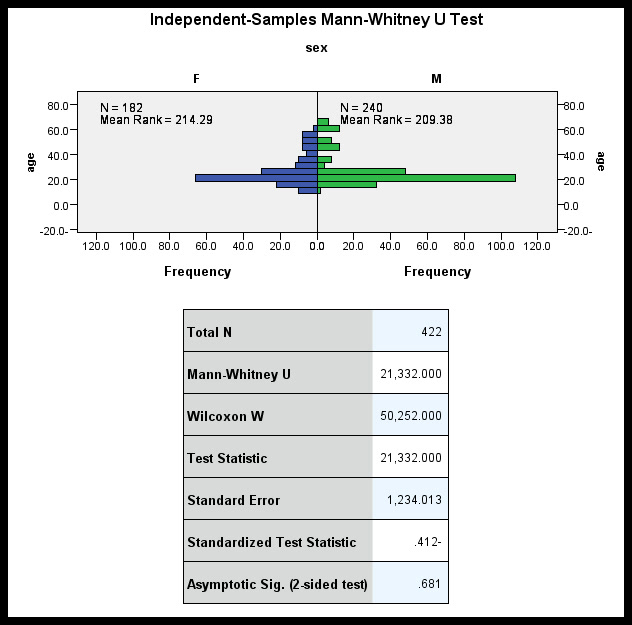
Das mittlere Alter betrug bei Frauen 27,44 und bei Männern 27,55 Jahre (Tabelle 14). Der Mann-Whitney-Test zeigte keinen signifikanten Unterschied (p = 0,681; Abb. 46).
Tabelle 14: Frauen Mittelwert 27,44, KI 25,69–29,18, Median 23, SD 11,906, Minimum 11, Maximum 61; Männer Mittelwert 27,55, KI 25,91–29,20, Median 23, SD 12,933, Minimum 11, Maximum 67.
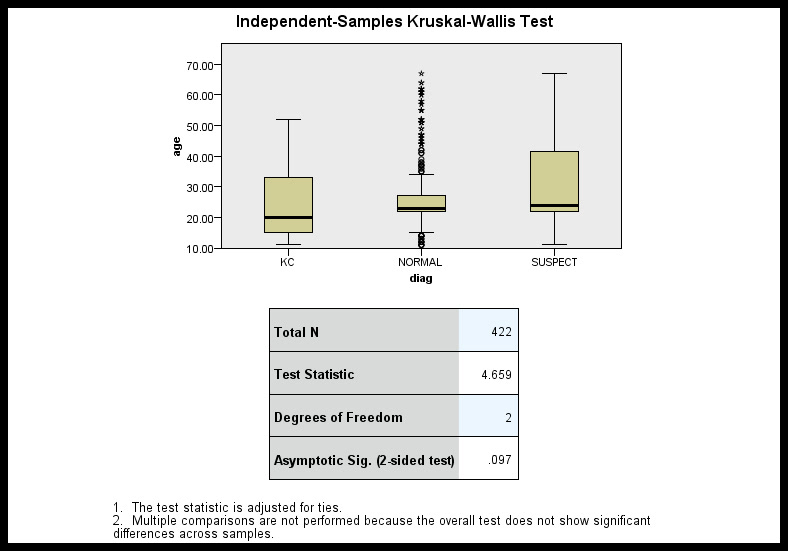
Nach Diagnose lagen die Mittelwerte bei KC 25,92 (11–52 Jahre), NORMAL 27,02 (11–67 Jahre) und SUSPECT 32,11 (11–67 Jahre). Der Kruskal-Wallis-Test zeigte keinen signifikanten Unterschied (p = 0,097; Tabelle 15; Abb. 47).
Tabelle 15: KC Mittelwert 25,92, KI 17,65–34,19, Median 20, SD 13,689, Minimum 11, Maximum 52; NORMAL 27,02, KI 25,80–28,24, Median 23, SD 11,890, Minimum 11, Maximum 67; SUSPECT 32,11, KI 27,19–37,04, Median 24, SD 16,001, Minimum 11, Maximum 67.
5.6 Studienmethoden
5.6.1 Teil 1
Nach Anwendung der genannten Ein- und Ausschlusskriterien wurden Patientenakten und SIRIUS-Topographiebilder eingesehen und die Daten extrahiert. Die Bilder wurden auf einer Klyce/Wilson-Skala mit einem Durchmesser von 9 mm ausgewertet (Wilson, Klyce, & Husseini, 1993), mit Ausnahme der Höhenkarte mit 8 mm Durchmesser und einem torisch-ellipsoidalen Float-Referenzkörper (Mazen M. Sinjab, 2018c). Auf Grundlage der verfügbaren Informationen wurden die Bilder entsprechend den in Kapitel 2.8 genannten Kriterien in drei Gruppen eingeteilt: eindeutiger Keratokonus; keratokonusverdächtige und Forme-fruste-Hornhäute; normale Hornhäute.
An den extrahierten Daten wurde eine deskriptive statistische Untersuchung durchgeführt. Die Kartenbilder wurden zum Training eines KI-Systems verwendet, das auf Computer Vision und Deep Learning beruht. Das System besteht aus elf künstlichen neuronalen Netzen: zehn Netze lesen jeweils eine topographische Karte - vordere und hintere sagittale Krümmung, vordere und hintere tangentiale Krümmung, Hornhautdicke, vordere und hintere Höhe sowie vordere, hintere und äquivalente Brechkraft - und ein elftes Netz trifft anhand dieser Ergebnisse die endgültige Klassifikationsentscheidung. Für Aufbau und Training wurden Python 3.6, TensorFlow 1.8 und Keras 2.2.3 mit TensorFlow-Backend verwendet.
5.6.2 Teil 2
Alle Patientinnen und Patienten beziehungsweise ihre gesetzlichen Vertreter unterschrieben vor der Teilnahme eine Einwilligungserklärung. Die klinische Befragung umfasste neben persönlichen Daten die medizinische, okuläre, medikamentöse und familiäre Anamnese. Die augenärztliche Untersuchung umfasste Sehschärfeprüfung mit der Snellen-Tafel, Untersuchung des vorderen Augenabschnitts und des Fundus, Refraktionsbestimmung, Aufnahme eines topographischen Bildes und die abschließende Klassifikation des Bildes anhand aller Informationen.
Ein Arzt beurteilte die Bilder ohne Kenntnis der Patientendaten nach den Kriterien aus Kapitel 2.8. Die Bilder wurden in das KI-System eingegeben und zusätzlich mit der am SIRIUS-Gerät angeschlossenen Software Phoenix v2.0.0.3 klassifiziert. Weiterhin klassifizierte der Arzt die Bilder mit Unterstützung der SIRIUS-Keratokonus-Zusammenfassung (Keratoconus Summary) sowie mit Unterstützung des KI-Systems, wobei die Einzelergebnisse jeder Karte und das endgültige Systemergebnis sichtbar waren.
Die Intrarater-Reliabilität des Arztes wurde untersucht, indem 100 zufällig aus der Trainingsgruppe ausgewählte Bilder zu zwei verschiedenen Zeitpunkten gelesen und die Ergebnisse mit Cohens Kappa verglichen wurden. Der Wert betrug 0,925 (p = 0, p < 5 %), was als ausgezeichnet gilt und die Verwendung der ärztlichen Ergebnisse unterstützt.
5.6.3 Trainingsprozess
Architektur der Kartennetze: Es wurden zehn strukturell gleiche Netze verwendet, je eines pro Karte. Die Eingabeschicht hatte die Größe 3×400×400. Es folgten drei konvolutionale Schichten mit 32, 32 und 64 Filtern der Größe 3×3; auf jede Schicht folgte eine 2×2-Pooling-Schicht. Danach kamen eine Flattening-Schicht, eine verborgene Schicht mit 64 Neuronen und eine Ausgabeschicht mit drei Neuronen.
Netz für die endgültige Entscheidung: Dieses Netz erhielt die Ausgaben der zehn Kartennetze als 30 Eingaben. Es folgten drei verborgene Schichten mit 64, 32 und 16 Neuronen sowie eine Ausgabeschicht mit drei Neuronen.
Zur Vermeidung von Overfitting wurde in den Kartennetzen ein L2-Regularisierer mit dem Wert 0,001 auf die verborgene Schicht mit 64 Neuronen angewendet; anschließend wurde eine Dropout-Schicht mit 0,3 eingefügt. Im Entscheidungsnetz wurde der L2-Regularisierer mit 0,001 auf die letzte verborgene Schicht mit 16 Neuronen angewendet, gefolgt von Dropout 0,3.
Die Trainingsgruppe wurde ohne Cross-Validation in 80 % Training und 20 % Validierung geteilt. Der Prozess wurde beendet, wenn sich der Validierungsverlust nach zehn Epochen nicht verbesserte. Gespeichert wurde das Modell mit dem geringsten Validierungsverlust. Abschließend wurden alle trainierten Netze auf die Testgruppe angewendet.
Wegen der kleinen Stichprobe wurde Data Augmentation eingesetzt. Da jedes Bild eine Symmetrie zur vertikalen Linie aufweist, verdoppelt horizontales Spiegeln die Trainingsstichprobe. Zusätzlich wurde Transfer Learning verwendet: Ein Basismodell wurde nacheinander mit allen erzeugten Bildern aller Karten (mehr als 30.000 Bilder) trainiert und anschließend zum Training jedes einzelnen Kartennetzes verwendet.
Wegen des Klassenungleichgewichts mit einem hohen Anteil normaler Fälle wurde ein gewichteter Loss eingesetzt. Der Verlust keratokonischer und verdächtiger Fälle wurde erhöht und der Verlust normaler Fälle verringert, um Underfitting zu vermeiden.
5.6.4 Primäre Forschungsendpunkte
Untersucht wurden die Genauigkeit jedes einzelnen Netzes und die Gesamtgenauigkeit des Systems bei Vorhersagen in Trainings-, Validierungs- und Testgruppe. Anschließend wurden in der Testgruppe die Gesamtgenauigkeiten des vorgeschlagenen KI-Systems (AI), des Arztes (DR), der SIRIUS-Software (CSO), des Arztes mit KI-Unterstützung (DR&AI) und des Arztes mit SIRIUS-Software-Unterstützung (DR&CSO) verglichen.
5.6.5 Statistische Datenanalyse
Mithilfe von Confusion-Matrices wurden Sensitivität, Spezifität, positiver und negativer prädiktiver Wert, F1-Score und Genauigkeit in Trainings-, Validierungs- und Testgruppe berechnet. Die Prävalenz beeinflusst die prädiktiven Werte; für die Berechnung wurden die Anteile der Testgruppe verwendet. Bei unausgewogenen Gruppen und besonderem Interesse an falsch-positiven und falsch-negativen Ergebnissen gilt der F1-Score als geeigneter als die reine Genauigkeit (Sokolova, Japkowicz, & Szpakowicz, 2006). Der McNemar-Test wurde verwendet, um die Ergebnisse der neuronalen Netze mit den Ergebnissen des Arztes mit und ohne KI-Unterstützung sowie mit und ohne SIRIUS-Software-Unterstützung zu vergleichen (Hoffman, 1976).