Kapitel 3 · vollständige deutsche Übersetzung
Künstliche Intelligenz
Kapitel 3: Künstliche Intelligenz (Artificial Intelligence)
- Einführung in die künstliche Intelligenz
- Überblick über die in der künstlichen Intelligenz verwendeten Techniken
- Künstliche neuronale Netze
- Deep-Learning-Netze und Computer-Vision-Technik
- Herausforderungen und Lösungen im Trainingsprozess
3.1 Einführung in die künstliche Intelligenz
3.1.1 Einleitung
Seit langer Zeit versucht der Mensch zu verstehen, wie Denken funktioniert - einschließlich der Wahrnehmung und Interpretation der Realität sowie der Vorhersage und Verarbeitung von Informationen. Künstliche Intelligenz bezeichnet die Nachahmung menschlicher Intelligenz in Maschinen, die so programmiert sind, dass sie wie Menschen denken und insbesondere lernen und Probleme lösen. Die ernsthafte Forschung begann nach dem Zweiten Weltkrieg; die heutige Bezeichnung entstand 1956. Für Wissenschaftlerinnen und Wissenschaftler sind die Möglichkeiten weiterhin offen.
3.1.2 Begriff (Russell & Norvig, 2002a)
Definitionen der künstlichen Intelligenz unterscheiden sich je nach Forschenden und Fachgebiet. Im Mittelpunkt stehen einerseits Denk- und Schlussfolgerungsprozesse im Gegensatz zum Verhalten und andererseits menschliche Leistung im Gegensatz zu idealer Leistung. Aus der Verbindung dieser Achsen ergeben sich vier untersuchte Konzepte:
- Menschliche Leistung: verkörpert durch den von Alan Turing 1950 entwickelten Turing-Test. Eine Maschine gilt als intelligent, wenn sie Fragen eines menschlichen Prüfers beantworten kann, ohne dass dieser erkennen kann, ob die Antwort von einem Menschen oder einer Maschine stammt.
- Menschliches Denken: ein Beispiel ist der General Problem Solver von Newell und Simon (1961). Die Forschenden versuchten, dieselben Schritte zu verwenden, mit denen Menschen Probleme lösen, unabhängig davon, wie genau das Ergebnis ist.
- Rationales Denken: Es stützt sich auf Aristoteles’ Ideen zur Entwicklung korrekter Regeln für Denken und Schlussfolgern, also auf Logik. Wenn Ahmad größer als Mohammad und Mohammad größer als Said ist, folgt daraus, dass Ahmad größer als Said ist.
- Rationales Handeln: Ziel ist das bestmögliche erwartete Ergebnis. Dazu gehört logisches Denken durch Schlussfolgerung. In manchen Situationen gibt es jedoch keine eindeutig richtige Handlung; eine Option kann nur wahrscheinlicher besser sein als eine andere. Auch Reflexhandlungen, etwa das Zurückziehen der Hand nach Berühren einer heißen Oberfläche, können die beste Option sein, ohne dass eine ausführliche Schlussfolgerung abgewartet wird.
3.1.3 Historischer Überblick (Mijwel, 2015; Russell & Norvig, 2002a)
Warren McCulloch und Walter Pitts entwickelten das erste Modell künstlicher Neuronen. Es reagierte, wenn von den verbundenen umgebenden Neuronen ein ausreichender Reiz einging. Grundlage waren physiologische Erkenntnisse über Neuronen, logische Analyse und Turings Berechnungstheorie, etwa zum Aufbau logischer Gatter (NOT, OR, AND). Weitere Forschung folgte. Die Epoche wurde durch Turings Vorschläge geprägt: den Turing-Test und die Idee, eher den lernfähigen Geist eines Kindes als die Denkweise eines Erwachsenen nachzuahmen.
John McCarthy begründete das Fach, indem er 1956 zehn Wissenschaftler für zwei Monate an der Dartmouth University in Hanover versammelte. Ein wichtiges Ergebnis war der Logic Theorist (LT) von Allen Newell und Herbert Simon. Er ermöglichte es Computern, logisch statt nur numerisch zu denken und Probleme zu lösen, und begründete eine Forschungsgemeinschaft, die das Gebiet in den folgenden Jahren weiterentwickelte.
Es folgte eine Blütezeit mit zahlreichen KI-Anwendungen, die zeigten, dass Computer mehr als Rechenoperationen leisten konnten: der General Problem Solver (Newell und Simon), ein System zum Beweisen geometrischer Lehrsätze (Herbert Gelernter, 1959) und ein Schachprogramm (Arthur Samuel), dessen Leistung sich verbessern und schließlich den Entwickler schlagen konnte. McCarthy entwickelte die Programmiersprache LISP, die lange als KI-Sprache verwendet wurde. Gleichzeitig begrenzten geringe Ressourcen und die schwache Leistungsfähigkeit damaliger Computer die Forschung.
Ende der 1960er und Anfang der 1970er Jahre wurde deutlich, dass der übermäßige Optimismus einiger Forschender die Möglichkeiten der KI überschätzt hatte. Er beruhte auf Experimenten in einer begrenzten Umgebung, die nicht auf die Realität übertragbar waren. Auch Aufgaben wie maschinelle Übersetzung, die von der US-Regierung unterstützt worden waren, erwiesen sich als wenig erfolgreich; die Unterstützung wurde eingestellt. Die verbreitete Annahme, die damaligen Grenzen der KI seien ausschließlich auf die begrenzte Rechenleistung zurückzuführen, war ebenfalls unzutreffend.
Es kam zu einer Phase der Stagnation, unter anderem bei künstlichen neuronalen Netzen. Die frühere Forschung hatte sich auf allgemeine intelligente Systeme konzentriert, die praktisch keine guten Ergebnisse erzielten; ihre Bedeutung beschränkte sich auf einige Spiele und einfache Aufgaben, und die staatliche Unterstützung ging zurück. Danach konzentrierte man sich auf Systeme zur Lösung spezifischer Probleme. Das erste Expertensystem war DENDRAL. Es sollte anhand spektroskopischer Signale die Zusammensetzung des Bodens auf dem Mars analysieren. Dazu wurden Fachleute einbezogen und regelbasierte Wissensbestände aufgebaut. In dieser Zeit entstanden zahlreiche Expertensysteme; Programmiersprachen und Computertechnik entwickelten sich parallel.
Ende der 1980er Jahre waren die Voraussetzungen für eine Rückkehr künstlicher neuronaler Netze geschaffen. Aus den Erfahrungen der Vergangenheit wurde gelernt, der Schwerpunkt auf spezifische Aufgaben gelegt und die Entwicklung von Programmiersprachen und Computern genutzt. Vor allem die Fortschritte bei Lernalgorithmen, insbesondere Backpropagation, führten zu einer kraftvollen Rückkehr künstlicher neuronaler Netze in viele Anwendungsbereiche.
3.2 Überblick über Techniken der künstlichen Intelligenz
Die KI-Techniken entwickelten sich parallel zu unserem Verständnis der künstlichen Intelligenz. Zu den wichtigsten gehören:
3.2.1 Suchalgorithmen (Search Algorithms)
Suchalgorithmen gehören zu den frühesten Techniken. Sie versuchen, alle möglichen Züge zu prüfen, wie beim Schach. Zunächst wurde blind und ungerichtet gesucht, was Geschwindigkeit und Komplexität der Aufgabe belastete. Später wurden heuristische Suchverfahren entwickelt, die die Algorithmen effizienter machten. Ein bekanntes Beispiel ist das Dameprogramm von Samuel (Jones, 2008).
3.2.2 Expertensysteme (Expert Systems)
Die Grundidee besteht darin, Wissen eines menschlichen Experten zu einem bestimmten Thema auf einen Computer zu übertragen. Ein Knowledge Engineer übernimmt diese Aufgabe, indem er Informationen als Regeln dokumentiert. Über eine vorbereitete Benutzeroberfläche erhält die Nutzerin oder der Nutzer anschließend auf Grundlage der eingegebenen Daten eine Empfehlung und eine Erklärung (Liao, 2005).
DENDRAL ist eines der bekanntesten Expertensysteme. Es wurde zur chemischen Analyse des Marsbodens verwendet, um aus spektroskopischen Signalen die Molekülstruktur zu bestimmen. Die hierfür benötigten Regeln wurden von Fachleuten erstellt, da der Versand herkömmlicher Analysegeräte nicht möglich war (Feigenbaum & Buchanan, 1994). Expertensysteme liefern im Gegensatz zu Menschen feste Ausgaben ohne Kreativität. Fehler bei der Wissensübertragung führen zu falschen Ergebnissen. Außerdem sind Entwicklung und Änderung bei Erweiterung oder Anpassung der Regeln kostenintensiv (Cowan, 2001; Partridge, 1987).
3.2.3 Maschinelles Lernen (Machine Learning)
Maschinelles Lernen kann einfach als Lernen anhand von Beispielen beschrieben werden. Es umfasst (Bonaccorso, 2017; Jatana, 2019):
- Überwachtes Lernen (Supervised Learning): Es gibt eine Referenz dafür, was richtig und falsch ist; die Leistung wird durch Verringerung des Fehlers verbessert. Regressionsalgorithmen haben kontinuierliche numerische Ausgaben, etwa Blutdruck oder Gewicht. Beispiele sind lineare Regression, Support Vector Machine (SVM), Entscheidungsbaum, Random Forest, Boosting und neuronale Netze. Klassifikationsalgorithmen liefern eine bestimmte Klasse, etwa die Zuordnung eines Bildes zu einer von drei Klassen. Beispiele sind logistische Regression, Naive Bayes, SVM, Entscheidungsbaum, Random Forest, Boosting und neuronale Netze.
- Unüberwachtes Lernen (Unsupervised Learning): Es gibt keine Referenz; Beziehungen innerhalb der Daten werden extrahiert und nach Ähnlichkeit gruppiert. Ein bekannter Algorithmus ist K-means.
- Bestärkendes Lernen (Reinforcement Learning): Es gibt weder Lehrperson noch Referenz. Der Lernprozess wird beim Training über ein Belohnungs- und Bestrafungssystem gesteuert. Dies ist in einer sich kontinuierlich verändernden, nicht vollständig vorhersehbaren Umgebung wichtig, etwa in Videospielen mit einem langfristigen strategischen Ziel und kurzfristigen Teilzielen. Bestärkendes Lernen kann unmittelbare rationale Entscheidungen treffen und einen kurzfristigen Verlust zugunsten eines langfristigen Gewinns akzeptieren.
3.2.4 Evolutionäre und genetische Algorithmen
Diese Algorithmen beruhen auf Grundprinzipien der Biologie, der Evolutionstheorie, der natürlichen Selektion, spontaner Mutation und des Überlebens der am besten Angepassten. Geeignete Merkmale für die Lösung eines Problems werden gefunden, indem Generationen mit ungünstigen Merkmalen aussterben und Generationen mit günstigen Merkmalen durch Kreuzung und zufälligen Austausch dieser Eigenschaften bei der Bildung der nächsten Generation erhalten und verstärkt werden. Eine geringe Rate zufälliger Mutationen kann neue, zuvor nicht vorhandene Eigenschaften hervorbringen, die bei der Problemlösung helfen (Coello, 2005; Yu & Gen, 2010).
3.3 Künstliche neuronale Netze
3.3.1 Begriff
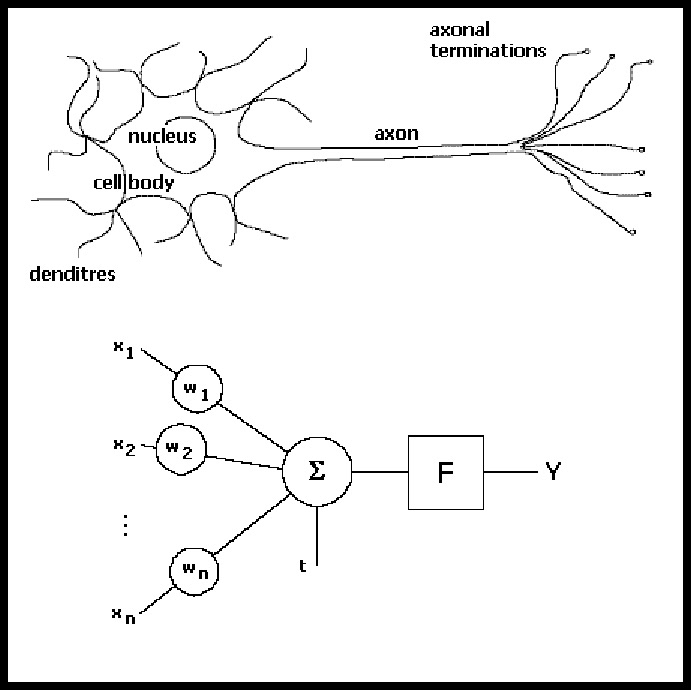
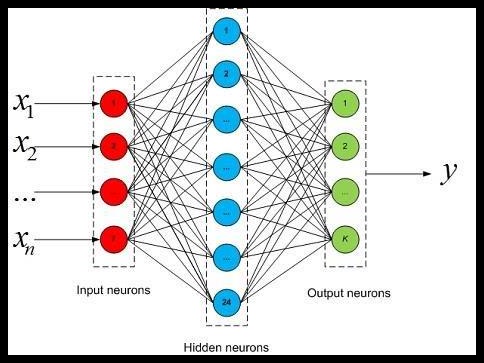
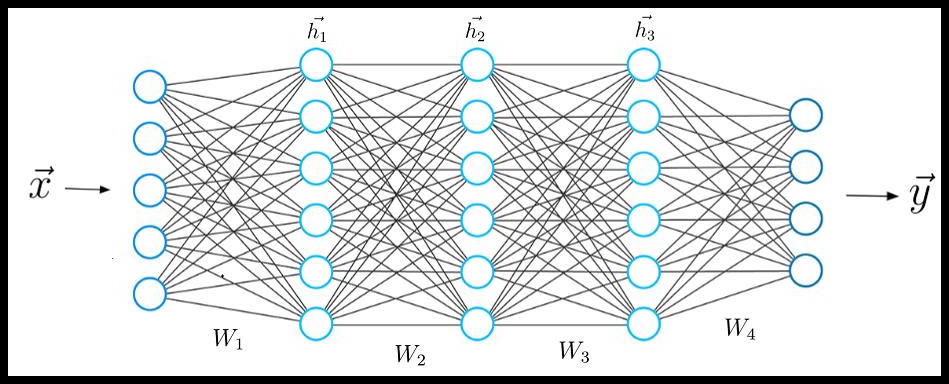
Die Idee künstlicher neuronaler Netze ist von biologischen Nervenzellen und ihren Verschaltungen im Gehirn inspiriert (Abb. 25). Jedes Neuron besteht aus Eingaben, einer Funktion und einer Ausgabe; dies entspricht den Dendriten, dem Zellkörper und dem Axon. In einem neuronalen Netz sind Neuronen in aufeinanderfolgenden Schichten verbunden. Die einfachste Struktur besteht aus Eingabeschicht, verborgener Schicht und Ausgabeschicht (Abb. 26). Jedes Neuron ist mit allen Neuronen der vorherigen und der nachfolgenden Schicht verbunden (Scarborough & Somers, 2006).
3.3.2 Training
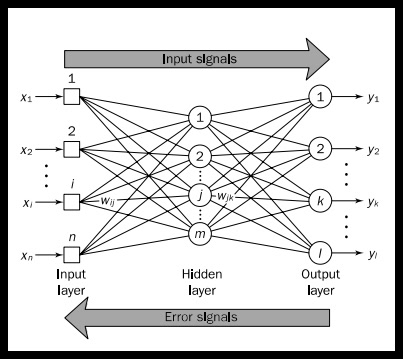
Das Netz wird mit einer Datenbank trainiert, die Eingaben und Ausgaben enthält. Die Daten werden in Trainings-, Validierungs- und Testgruppe aufgeteilt. Eingaben der Trainingsgruppe werden in das Netz eingespeist; die Ausgabe wird berechnet, mit dem tatsächlichen Wert verglichen und die Verbindungen innerhalb des Netzes werden angepasst, um den Fehler zu verringern. Der Fehler wird als Loss bezeichnet (Abb. 27). Das Training wird mehrfach wiederholt; in jedem Durchlauf wird die Genauigkeit an der Validierungsgruppe berechnet.
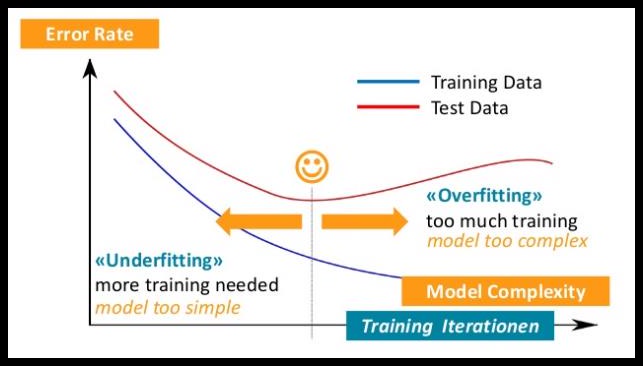
Typischerweise steigt die Genauigkeit in Trainings- und Validierungsgruppe zunächst an (Lernprozess). Ab einem bestimmten Punkt gehen die Gruppen auseinander: Die Trainingsgenauigkeit steigt weiter, während die Validierungsgenauigkeit sinkt. Dies ist Overfitting. Das Lernen endet dann faktisch in einem Auswendiglernen der Trainingsgruppe, wodurch die Leistung in der Validierungsgruppe schlechter wird (Abb. 28). Anschließend wird die Genauigkeit an einer unabhängigen Testgruppe berechnet; sie stellt das erwartete Ergebnis des Modells bei der Anwendung in der Praxis dar (Smola & Vishwanathan, 2008).
3.3.3 Vor- und Nachteile künstlicher neuronaler Netze
Vorteile: Neuronale Netze können komplexe und verschachtelte Beziehungen, nichtparametrische Beziehungen, schwache Beziehungen zwischen abhängigen und unabhängigen Variablen sowie eine hohe unerklärte Varianz modellieren. Sie sind auch dann einsetzbar, wenn keine klare theoretische Grundlage für Vorhersage oder Klassifikation formuliert werden kann (Scarborough & Somers, 2006; Sarle, 1994). Weitere Eigenschaften sind:
- keine feste Beschränkung des Typs von Eingaben und Ausgaben; qualitative und quantitative Variablen sowie Mischformen sind möglich;
- keine Vorannahmen über die statistische Verteilung der Variablen oder ihrer Beziehungen;
- keine feste Zahl von Eingaben und Ausgaben;
- hohe Recheneffizienz und daher Echtzeitanalyse;
- ein dynamisches, flexibles nichtlineares Regressionssystem (Niavarani & Wickramasinghe, 2014).
Nachteile (Hastie, Tibshirani, & Friedman, 2001): Ein gutes Modell benötigt ein gutes Training mit ausreichend großen und hochwertigen Daten. Es ist schwierig zu erkennen, was im Modell genau geschieht (Black Box); sichtbar sind im Wesentlichen nur Ein- und Ausgabe.
3.4 Deep Learning und Computer Vision
3.4.1 Deep Learning
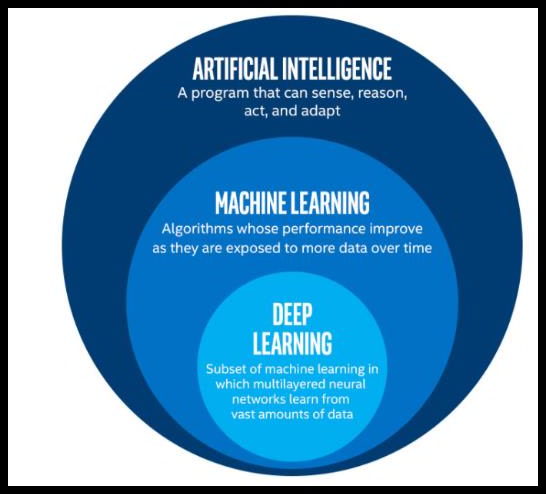
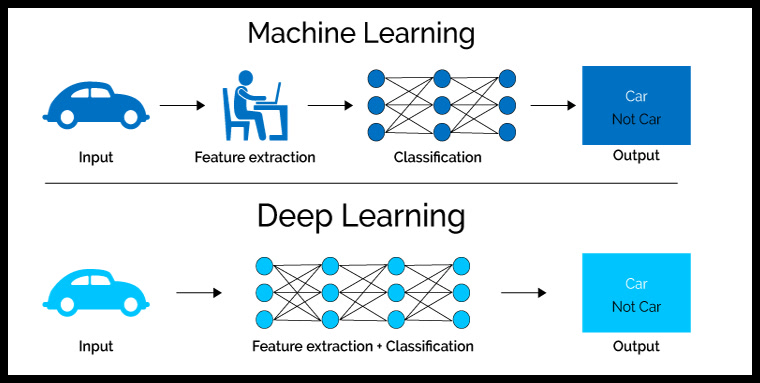
Deep Learning ist ein Teilgebiet des maschinellen Lernens (Abb. 29) und entstand zunächst 2006. Es wird vor allem zur Mustererkennung eingesetzt. Ein Netz besteht aus mehreren hierarchisch aufeinanderfolgenden Neuronenschichten (Abb. 30). Ziel ist, nützliche Informationen und Merkmale zu extrahieren. Dies unterscheidet Deep Learning von herkömmlichen maschinellen Lernverfahren, bei denen die nützlichen Merkmale vor der Klassifikation festgelegt und mit unabhängigen Techniken außerhalb des neuronalen Netzes extrahiert werden. Deep Learning kann überwacht oder unüberwacht erfolgen (Abb. 31; Vargas, Mosavi, & Ruiz, 2017).
3.4.2 Computer Vision und konvolutionale neuronale Netze
Computer Vision ist ein Teilgebiet der künstlichen Intelligenz. Algorithmen der Computer Vision sollen intelligente Anwendungen entwickeln, die den Inhalt von Bildern so verstehen können wie Menschen. Eine der häufigsten Techniken hierfür sind konvolutionale neuronale Netze (CNN). Sie sind mehrschichtige künstliche neuronale Netze und gehören deshalb zum Deep Learning. CNN können Bilder als Eingaben aufnehmen und über mehrere Neuronenschichten, die wie Filter arbeiten, Informationen extrahieren. Die Dimensionen werden schrittweise verkleinert, bis eine eindimensionale Neuronenmatrix entsteht, die mit weiteren Schichten verbunden wird. Die letzte Schicht enthält so viele Neuronen wie die zu erkennenden Klassen. Durch die geringere Zahl zu bestimmender Verbindungen im Vergleich zu herkömmlichen neuronalen Netzen sinkt die Wahrscheinlichkeit von Overfitting (O’Shea & Nash, 2015).
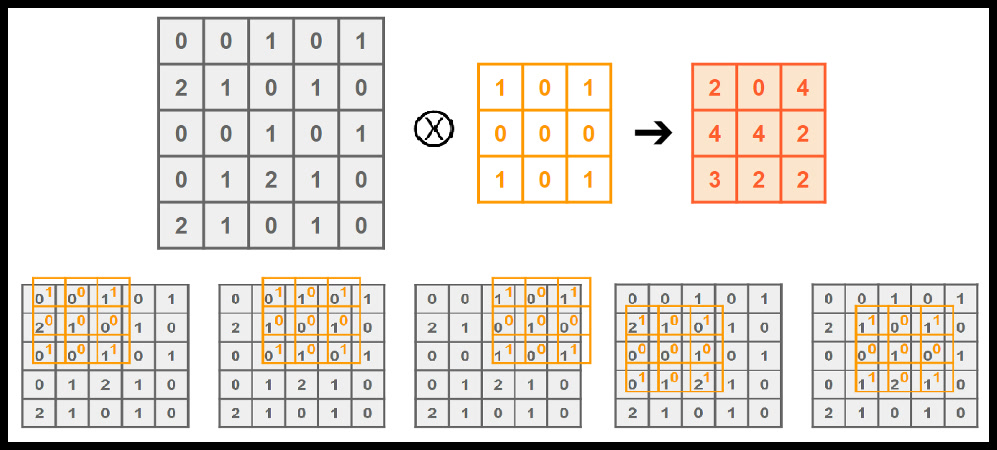
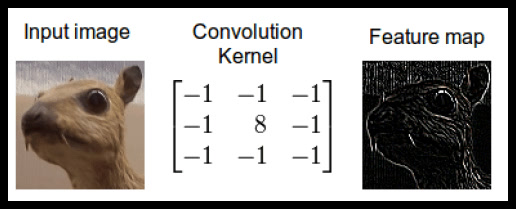
Konvolutionale Schicht (Convolutional Layer): Sie nimmt ein Eingabebild mit Länge, Breite und Tiefe auf und scannt es mit mehreren Matrizen. Jede Matrix besteht aus mehreren Neuronen und wird durch Multiplikation mit dem entsprechenden Bildausschnitt über das gesamte Bild bewegt. Das Ergebnis wird als Zahlenmatrix dargestellt; anschließend wird in der Aktivierungsschicht eine Aktivierungsfunktion angewendet, sodass mehrere Merkmalskarten entstehen - eine für jede Neuronenmatrix (Abb. 32–33). Die Matrizen arbeiten wie Filter und extrahieren wichtige Merkmale (Jeong, 2019).
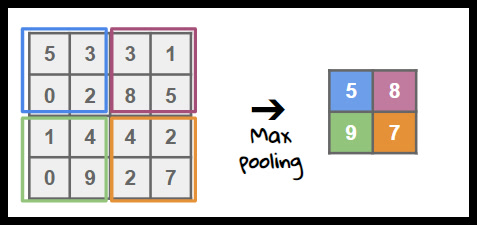
Pooling-Schicht (Pooling Layer): Sie reduziert schrittweise die Dimensionen der Ausgaben der konvolutionalen Schicht, ohne die Tiefe zu verändern. Beim verbreiteten Max-Pooling scannt eine Neuronenmatrix, beispielsweise 2×2, das Bild und wählt jeweils nur den höchsten Wert; die übrigen Werte werden verworfen. In diesem Beispiel wird die Bildgröße auf ein Viertel reduziert (Abb. 34; Jeong, 2019).
Aktivierungsschicht (Rectified Linear Units Layer): Sie besteht aus Neuronen, die auf die Ausgabe jedes Neurons der konvolutionalen Schicht eine Aktivierungsfunktion anwenden. Die resultierende Merkmalskarte hebt wichtige Merkmale hervor und unterdrückt unwichtige. Ein wesentliches Ziel ist die Beschleunigung des Trainings: Die Ausgabe jedes Neurons hängt nur von seiner Eingabe und nicht von den Werten anderer Neuronen ab (Abb. 33; Jeong, 2019).
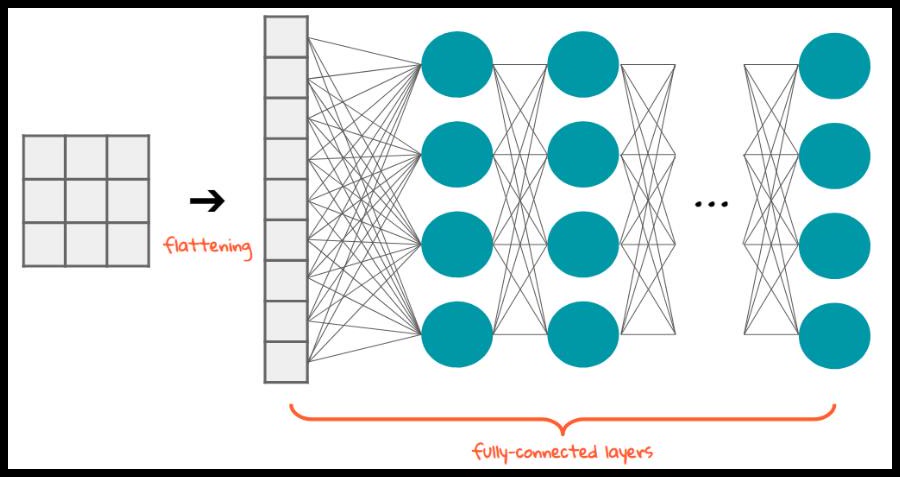
Flattening-Schicht: Eingabematrizen werden in einen eindimensionalen Vektor umgewandelt. Dieser Neuronenvektor bildet die Eingabeschicht eines herkömmlichen mehrschichtigen künstlichen neuronalen Netzes, das in einer Ausgabeschicht mit so vielen Neuronen wie trainierten Klassen endet (Abb. 35; Jeong, 2019).
Vollständig verbundene Schichten und Ausgabeschicht (Fully-Connected Layers and Output Layer): Mehrere Schichten enden in einer Ausgabeschicht mit einem Neuron pro trainierter Klasse und einer geeigneten Aktivierungsfunktion (Abb. 35; Jeong, 2019).
3.5 Herausforderungen und Lösungen im Trainingsprozess
Beim Training treten Probleme und Herausforderungen auf, die die Modellgenauigkeit beeinflussen. Einige, etwa Overfitting, sind allgemein; andere kommen im medizinischen Bereich häufiger vor, insbesondere unausgewogene Klassen und kleine Stichproben. Im Folgenden werden die wichtigsten Probleme und mögliche Lösungen zusammengefasst.
3.5.1 Overfitting
Das Problem wurde bereits im Abschnitt zum Training erläutert. Mögliche Techniken sind:
- Cross-Validation: Die Trainingsgruppe wird beispielsweise in fünf Teile aufgeteilt. Vier Teile werden zum Training und der fünfte zum Testen verwendet. Der Vorgang wird fünfmal wiederholt; jedes Teilstück dient einmal als Testgruppe. Die Populationsgenauigkeit kann durch den Mittelwert der fünf Testgenauigkeiten geschätzt werden (Moore, 2001).
- Regularisierung: Das Modell wird während des Trainings bestraft, damit es in einem bestimmten Maß einfacher wird (Russell & Norvig, 2002b). Bei L1 entspricht die Strafe der Summe der Absolutwerte der Gewichte. Merkmale mit Gewichten nahe null werden entfernt; das Modell wird leichter verständlich und die Zahl der verwendeten Merkmale sinkt. L2 ist häufiger und bestraft mit der Summe der quadrierten Gewichte. Die Gewichte nähern sich null, erreichen null aber nicht.
- Early Stopping: Das Training wird beim Auseinanderlaufen von Trainings- und Validierungsgenauigkeit beendet, sodass beide Genauigkeiten noch ähnlich sind (Sarle, 1996).
- Dropout: Verbindungen zwischen einigen Neuronen einer Schicht und der folgenden Schicht werden mit einer bestimmten Wahrscheinlichkeit zufällig aufgehoben. Dadurch wird Overfitting reduziert (Srivastava, Hinton, Krizhevsky, Sutskever, & Salakhutdinov, 2014).
3.5.2 Kleine Stichprobe (Small Dataset)
Dieses Problem ist in der Medizin häufig, weil Datenbanken mit Millionen Datensätzen selten sind, insbesondere bei medizinischen Bildern. Die Datenmengen umfassen meist Hunderte oder Tausende Fälle. Dies kann zu Underfitting führen, weil das trainierte Modell in der Population keine guten Ergebnisse erzielt. Zu den Lösungen gehören (Han, Liu, & Fan, 2018):
- Transfer Learning: Das Training eines Netzes, das bereits auf einer ähnlichen Aufgabe trainiert wurde, ist leichter als das Training von Grund auf. Wie bei einem Kind, das bereits Zahlen und Addition kennt, benötigt ein vortrainiertes Netz weniger Daten und weniger Zeit.
- Data Augmentation: Das Bild wird leicht verändert, etwa durch Rotation um einen bestimmten Winkel, horizontales oder vertikales Spiegeln oder Hinzufügen eines kleinen Rauschens. Dadurch entstehen neue, der ursprünglichen Stichprobe ähnliche Bilder. Bei kornealen Topographiekarten kann wegen der Symmetrie zur vertikalen Linie eine horizontale Spiegelung neue Trainingsbilder erzeugen.
3.5.3 Klassenungleichgewicht (Class Imbalance)
Dieses Problem tritt in der Medizin häufig auf, weil Krankheitsfälle viel seltener sind als Normalbefunde. Ein Modell, das mit 90 % normalen und 10 % krankhaften Fällen trainiert wird, kann 90 % Genauigkeit erreichen, indem es jeden Fall als normal klassifiziert. Bei der Anwendung in der Population entsteht dadurch ebenfalls Underfitting. Häufige Lösungen sind Sampling und Weighted Loss (Abd Elrahman, Abraham, & Computing, 2013; Buda, Maki, & Mazurowski, 2018).
Beim Sampling werden die Klassen ausgeglichen: Beim Over-Sampling wird die seltenere Klasse in der Trainingsgruppe durch wiederholtes Kopieren vergrößert. Dies kann Overfitting verursachen; SMOTE erzeugt deshalb ähnliche, aber nicht identische Fälle. Beim Under-Sampling werden Fälle der häufigeren Klasse gelöscht. Dies kann Underfitting verursachen; Verfahren wie GSVM-RU entfernen unwichtige und doppelte Fälle und erhalten wichtige Fälle.
Beim gewichteten Loss (Weighted Loss) wird der Trainingsverlust so gewichtet, dass ein Gleichgewicht zwischen den Klassen entsteht. Der Verlust der seltenen Klasse wird erhöht, der Verlust der häufigen Klasse verringert. Dazu wird der klassenbezogene Loss mit Gewichten multipliziert, die umgekehrt proportional zum Anteil der Klasse an allen Fällen der Trainingsgruppe sind.